
こんにちは。開発統括部のK.F.です。
突然ですが、BNF(バッカス・ナウア記法)って知ってますか?
基本情報技術者試験の勉強をしたことがある人ならこんな問題を解いたことがあると思います。
次のBNFで定義される<変数名>に合致するものはどれか。

<数字> ::= 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9
<英字> ::= A | B | C | D | E | F
<英数字> ::= <英字> | <数字> | _
<変数名> ::= <英字> | <変数名><英数字>

ア: _B39
イ: 246
ウ: 3E5
エ: F5_1
出典:令和元年 秋期 基本情報技術者試験 午前 問7
::= は左辺を右辺で定義という意味です。
| は「または」と読み替えてください。
<変数名> を展開して選択肢のどれに合致し得るかを考えます。
<英字> または <変数名><英数字> に展開されるわけですが、どちらに展開されても最終的には一番左に <英字> が来ることがわかります。
そのため正解は エ となります。
さて、こんなのいつ使うの?情報技術関係あるの?って思った人も少なくないはず。
かくいう私もそうでした。この夏の自由研究でその使われ方を知ったので紹介します。
BNFとは何か
BNFは文法規則を表現する方法で、コンパイラではこうした文法規則をもとに、文字列(プログラム)を構文木へ変換する構文解析が行われます。
例を挙げると、 "2 + 3 * 4" という文字列は以下のような構文木に変換されます。
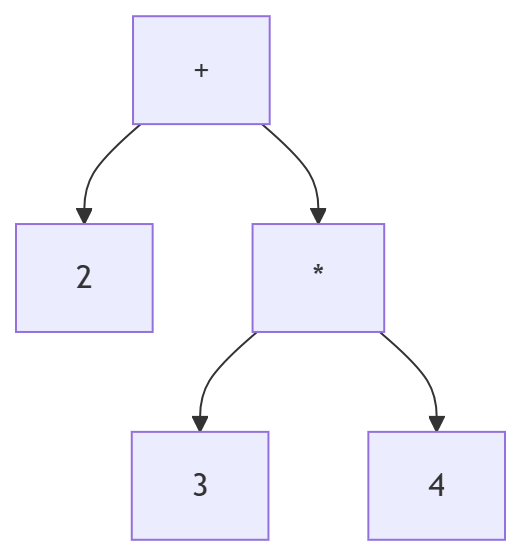
構文木の形から * が + よりも先に結合すること、つまり * の優先順位が高いことが読み取れると思います。
この構文木は以下の文法規則を考えることによって作ることができます。
expr ::= expr + term | term
term ::= term * nat | nat
nat ::= 0 | 1 | ...
優先順位
ここで、文法規則が expr と term に分かれている理由を考えてみましょう。
素直に考えると、以下のような文法規則が真っ先に思いつきます。
expr ::= expr + expr | expr * expr | nat
nat ::= 0 | 1 | ...
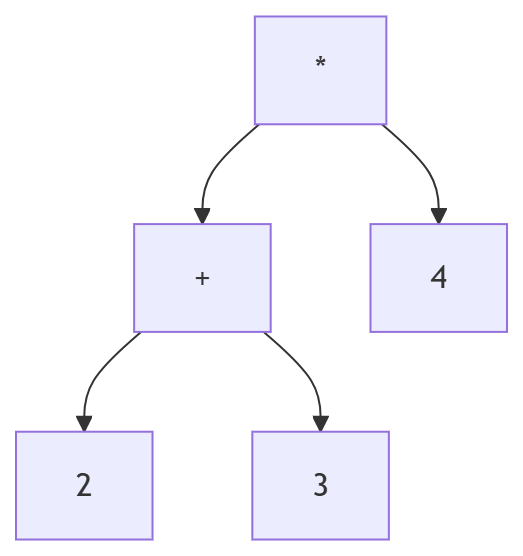
この文法規則で構文木を考えてみると、下の2通りができてしまいます。
2 + 3 * 4を(2 + 3) * 4ととった場合 (計算結果は20)
2 + 3 * 4を2 + (3 * 4)ととった場合 (計算結果は14)
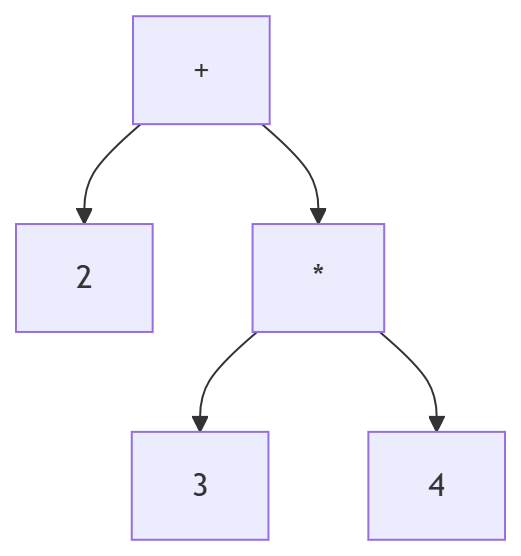
本来 * の方が優先順位が高いにもかかわらず、 + の方が先に結合した構文木ができてしまいます。
最初に挙げた文法規則をもう一度よく見てみましょう。
expr ::= expr + term | term
term ::= term * nat | nat
nat ::= 0 | 1 | ...
ポイントは expr の規則には term が現れるが、 term の規則には expr が現れないということです。
*の子はtermとnatだけで、ここからいくら展開してもexprは出てこず、+は*の下に絶対に来られない+の子にはtermがあるので、*は+の下に来られる
このように expr と term を分けることで、今回の式は意図した優先順位に従う1通りの構文木に定まります。
優先順位が文法規則によって表現されているというわけですね。
結合方向
さて、いままで例に挙げてきた +, * は同じ演算子が並ぶ限り、どちらから結合しても結果が変わらない演算でした。
2 + 3 + 4 = (2 + 3) + 4 = 2 + (3 + 4) = 9
2 * 3 * 4 = (2 * 3) * 4 = 2 * (3 * 4) = 24
次は -, / という、どちらから結合するかで結果が変わる演算を考えてみましょう。
例として "1 - 2 - 3" について考えてみます。
- だけを文法規則におとして考えてみると、以下が素朴に考えられます。
expr ::= expr - nat | nat
nat ::= 0 | 1 | ...
構文木に変換してみると以下のようになります。 (計算結果は -4)

これで問題なさそうですね。
ところで、この規則は expr - nat の順で書きましたが、 nat - expr と書いてもよさそうに見えます。
入れ替えるとどうなるか確かめてみましょう。
expr ::= nat - expr | nat
nat ::= 0 | 1 | ...
構文木に変換してみると以下のようになります。 (計算結果は 2)

このように、文法規則を少し変えるだけで - に期待する結果とは異なる構文木になってしまいました。
/ も同様なので、 -, / では expr ::= expr - nat | nat の形を採用する必要があります。
expr のように左側で再帰的に定義されていることを左再帰といい、左側から結合することを左結合といいます。
-, / は左結合の演算子ということですね。
右結合の演算はないでしょうか?
実は累乗を表す ^ は右結合の演算です。
2 ^ 3 ^ 2 = 2 ^ (3 ^ 2) = 2 ^ 9 = 512
(2 ^ 3) ^ 2 = 64 ではありません。
つまり、 ^ では先ほど - で不採用にした右再帰の形が正解ということになります。
expr ::= nat ^ expr | nat
nat ::= 0 | 1 | ...
ところで、前節で使った expr ::= expr + term | term も左再帰です。
+ はどちらから結合しても結果が変わらないので気づかなかったというわけですね。
- について考えた文法規則はどちらも1通りの構文木に変換されるため曖昧ではありませんでしたが、考える演算に合わせてどちらを選ぶかで意味が変わるということがわかりました。
括弧
これまでに考えた四則演算をまとめて文法規則にしておきましょう。
expr ::= expr + term | expr - term | term
term ::= term * nat | term / nat | nat
nat ::= 0 | 1 | ...
ここで、 - は + と同じ expr の段に、 / は * と同じ term の段に置いています。
つまり優先順位の節でみた性質がそのまま当てはまり、 * や / の下に + や - が来ることはありません。
演算を考えるにあたって、 * や / よりも + や - を強制的に優先して結合してほしいとき、 () を使って優先順位を変えると思います。
() を文法規則に含めることを考えてみましょう。
例として "1 + 2 * (3 - 4)" を考えます。
3 - 4 は上の文法規則から expr なので、 ( expr ) を含めないといけません。
また、2 * (3 - 4) を表現するためには term 以下で定義されないといけません。
これらを考えると以下のようになります。
expr ::= expr + term | expr - term | term
term ::= term * factor | term / factor | factor
factor ::= ( expr ) | nat
nat ::= 0 | 1 | ...
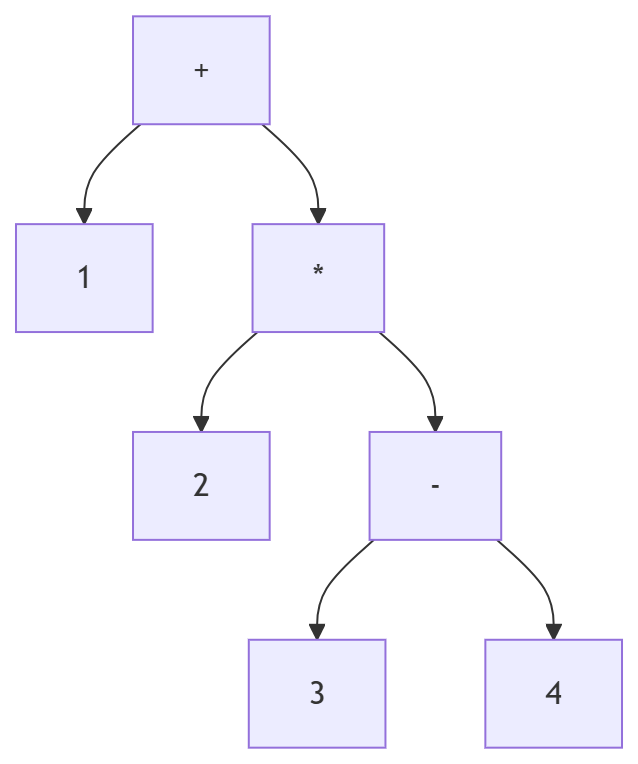
"1 + 2 * (3 - 4)" を構文木に変換すると以下のようになります。 (計算結果は -1)
優先順位の節では、「+ は * の下に絶対に来られない」と書きました。
上でまとめた文法規則では - も + と同じ段にいるので、 - についても同じことが言えるはずです。
ところがこの構文木では、 - が * の子になっています。
これは factor ::= ( expr ) という expr へ戻る循環を足したからです。
これまでの文法規則は expr から term、 nat へと下りていく一方通行でした。優先順位が固定されていたのは、この一方通行のおかげです。
factor ::= ( expr ) は、そこに戻り道を1本だけ足す規則でした。
私たちが当たり前に使っている「括弧の中を先に計算する」というルールが、たった1行で表現されているというわけですね。
まとめ
ここまで、優先順位・結合方向・括弧の3つを見てきました。
どれも「* が先」「- は左から」「括弧の中が先」という、計算するときに無意識に従っているルールです。
そしてどれも、文法規則の形によって表現されていました。
- 優先順位:
exprとtermに段を分け、下の段から上の段へ戻れないようにする - 結合方向: 再帰を左右どちらに置くか
- 括弧: 下の段から上の段へ戻る道を1本だけ足す
BNFは文法を書き並べるための記法に見えて、実は規則の形そのものが意味を運んでいるというわけですね。
さて、最初の問題に戻ってみましょう。
<変数名> ::= <英字> | <変数名><英数字>
これも左再帰です。
<変数名> を展開していくと、左端には必ず <英字> が残ります。
<変数名>
→ <変数名><英数字>
→ <変数名><英数字><英数字>
→ <変数名><英数字><英数字><英数字>
→ <英字><英数字><英数字><英数字>
つまりこの規則は、「1文字目は <英字>、2文字目以降は <英数字> が並ぶ」という形を表しています。
これがわかれば選択肢は一目で判定できます。
- ア
_B39… 1文字目が_で<英字>ではない - イ
246… 1文字目が2で<英字>ではない - ウ
3E5… 1文字目が3で<英字>ではない - エ
F5_1… 1文字目のFは<英字>、以降の5_1はすべて<英数字>
そして「1文字目に数字を置けない」というのは、多くのプログラミング言語が変数名に課しているルールそのものです。
「こんなのいつ使うの?」と思っていたあの問題は、実際のプログラミング言語の文法定義のミニチュアだった、というわけですね。
BNFは、私たちが毎日書いているコードをコンピュータが読むために使われている記法でした。
当たり前に使っているものも、その土台にある考え方を覗いてみると、なかなか面白いものですね。
参考書籍:プログラミングHaskell第2版
おわりに
KENTEMでは、様々な拠点でエンジニアを大募集しています! 建設×ITにご興味頂いた方は、是非下記のリンクからご応募ください。 recruit.kentem.jp career.kentem.jp
